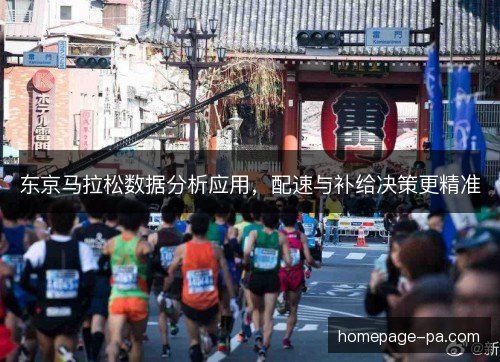
东京马拉松数据分析应用正在把配速与补给从经验判断推向可计算决策,这件事值得关注。东京马拉松赛道坡度、气温、湿度和补给站分布并不均匀,跑者只凭感觉安排前程,容易在三十公里后掉速或补给出错。应用把历史成绩、实时心率与赛道数据放在一起,让每段配速和进水进食更有依据,也把赛事服务推向更细层面。
东京马拉松赛前,组织方与参赛者开始把赛道分段数据输入东京马拉松数据分析应用。应用收录每五公里的坡度变化、补给站位置、关门时间与历史天气,也接入跑者近半年的训练记录。过去分散在报名资料、手表和教练笔记里的信息,第一次被整理成可比较的赛前档案,配速与补给不再只靠口口相传。
东京马拉松数据分析应用会先让跑者填写目标成绩与伤病史,再按赛道坡度生成分段配速。上坡段适当降速,下坡段避免猛冲,起跑五公里则设置上限,防止被周围人流带快。应用还把东京马拉松历年完赛数据作为参照,标出容易拥堵的弯道和补水点,让配速表从静态数字变成可执行的比赛脚本。
补给安排同样被拆成可计算节点。东京马拉松数据分析应用结合跑者体重、预计出汗量、气温和补给站间距,给出进水与能量胶的时间窗口。天气偏热时提前补充电解质,肠胃敏感的跑者则减少单次摄入量。东京马拉松沿途补给品类多,应用会标出哪些站点提供水、运动饮料和食物,减少临场犹豫。
比赛日,东京马拉松数据分析应用通过手表和心率带接收实时数据,把当前配速与赛前脚本对照。若连续两公里快于目标,界面提示收住节奏;若心率异常升高,则建议在下一个补给站降速补水。东京马拉松人流密集,跟跑容易打乱计划,实时提醒让跑者依据自身状态调整,而不是被身边速度带走。
东京马拉松的赛道特点放大了精准决策的价值。城市道路起伏不断,桥面与高楼之间风速变化明显,二月气温也可能忽冷忽热。三十公里后,糖原储备接近低位,配速和补给稍有偏差就会引发抽筋或撞墙。东京马拉松数据分析应用把这些变量提前纳入模型,让跑者在最困难的赛段少做仓促判断。
过去跑东京马拉松,配速多靠手表看当下,补给多靠记住大致站点。信息碎片化让跑者很难判断前半程是否过快,也容易在拥挤补给站错过取水。教练经验虽有价值,却难以覆盖不同体重、不同训练负荷的个体差异。PLAYACE官网东京马拉松数据分析应用把这些分散判断集中起来,减少赛前计划和临场执行之间的落差。
精度提升来自个人模型,而不是一套统一模板。东京马拉松数据分析应用会读取跑者最近几次长距离训练、半马成绩和心率漂移,估算其耐力曲线。同样是目标四小时,有人适合前慢后快,有人需要全程匀速。东京马拉松赛道的坡度数据再与个人曲线叠加,分段配速就能更贴近真实能力,避免盲目照搬他人方案。
补给精准直接影响身体负担。东京马拉松数据分析应用把水分、盐分和能量摄入拆到每个补给站,提醒跑者小口多次,而不是到口渴才猛喝。气温较高时,电解质补充提前,气温偏低时避免过量饮水。东京马拉松补给站间距有限,提前规划取水位置能减少急停和横向穿插,也让肠胃在高速奔跑中更稳定。
对大众跑者而言,东京马拉松数据分析应用降低的是撞墙概率。过去不少人前半程跟着气氛冲,后半程只能步行;现在分段配速与补给提醒把节奏拉回可控范围。东京马拉松参赛规模大,完赛时间跨度长,应用还能依据关门时间给出保守方案,让首次参赛者把安全完赛放在成绩之前,减少医疗点压力。
赛事组织同样从东京马拉松数据分析应用中受益。补给站可以根据报名成绩分布预测人流,把水和食物提前分配到需求更集中的时段。医疗点布置也能参考历史抽筋、低钠血症和失温案例,在风险较高的赛段增加人手。东京马拉松的志愿者调度因此更有依据,补给站排队和赛道拥堵也能被提前看见。
数据并非万能,东京马拉松数据分析应用也有边界。跑者输入的训练记录可能不完整,手表心率在低温下会漂移,算法给出的建议只能作为参考。过度依赖提示还会让人忽略头晕、发冷和胃部不适等身体信号。应用需要把不确定性讲清楚,让配速与补给建议保留调整空间,而不是制造新的焦虑。
东京马拉松数据分析应用要继续提升可信度,还要处理数据治理问题。跑者的心率、体重和伤病史属于敏感信息,授权范围和保存期限必须明确。算法若只服务少数精英跑者,大众建议就容易失真。东京马拉松组织方、计时服务商和教练团队需要共同校准数据口径,让应用在不同能力层级上都给出可靠建议。
往后看,东京马拉松数据分析应用会向实时联动走得更深。赛前模型可以接入公共气象更新,比赛日根据湿度和体感温度重新计算补给节奏。可穿戴设备若监测到步频下降、心率漂移,应用就能提示下一公里降速或提前补给。东京马拉松的赛道数据也会在赛后回传,帮助跑者复盘哪一段超速、哪一次取水被错过。
当数据采集、算法解释和隐私保护逐步成熟,东京马拉松数据分析应用的价值会从赛前工具变成比赛日的基础服务。它不替跑者做决定,而是把赛道、身体和补给之间的关系摆得更清楚。东京马拉松也会因此积累更细的赛事知识,让配速建议和补给安排在下一年更贴近真实需要,帮助更多人稳稳跑过终点。